英会話アプリでは「正確な文字起こし」が必ずしも正解ではない理由
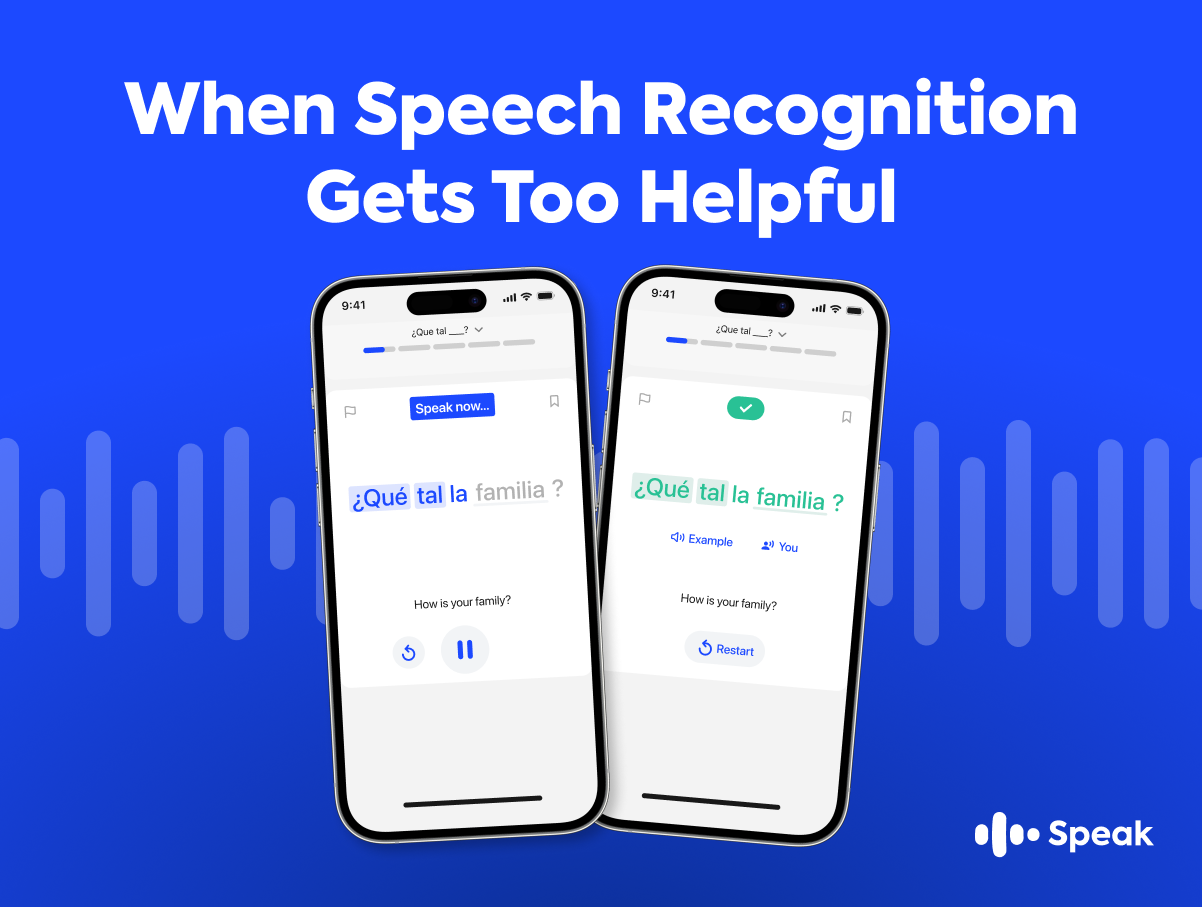
スピークでは、言語を学ぶ人にとって、どのような音声文字起こしが最適なのかを日々深く考えています。
スピークでできること
学ぶ
人間の先生の動画で、まずインプット。聞くだけではなく、先生に合わせて自分も声に出します。
練習する
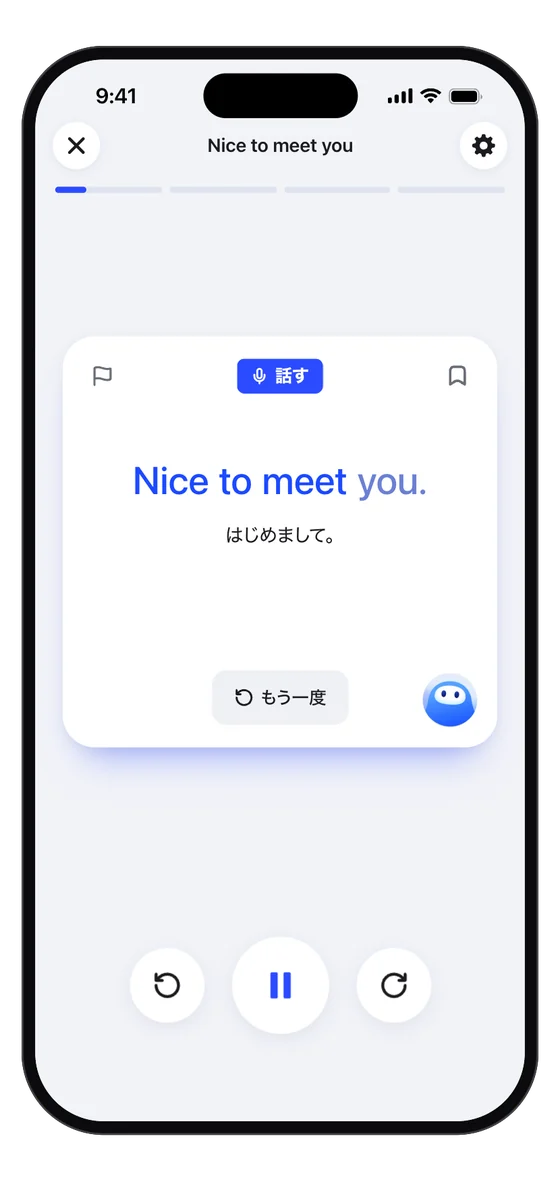
お手本を聞いてから、習った表現を何度も声に出します。考えなくても口から出てくるまで練習します。
実践する
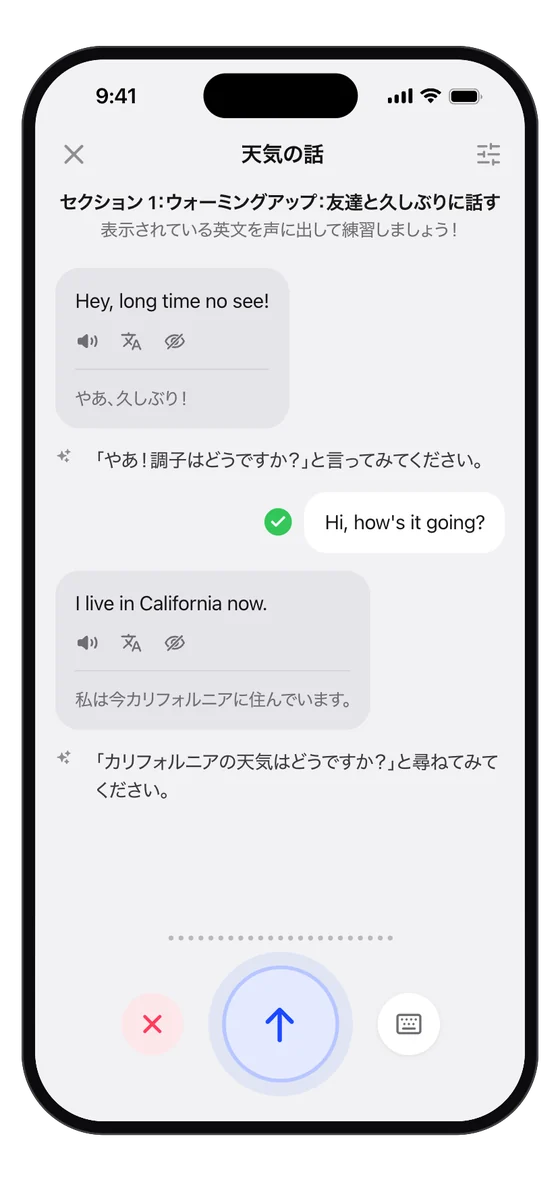
AIが話し相手。緊張せず、何度でも間違えながら、学んだ表現を使って話せます。
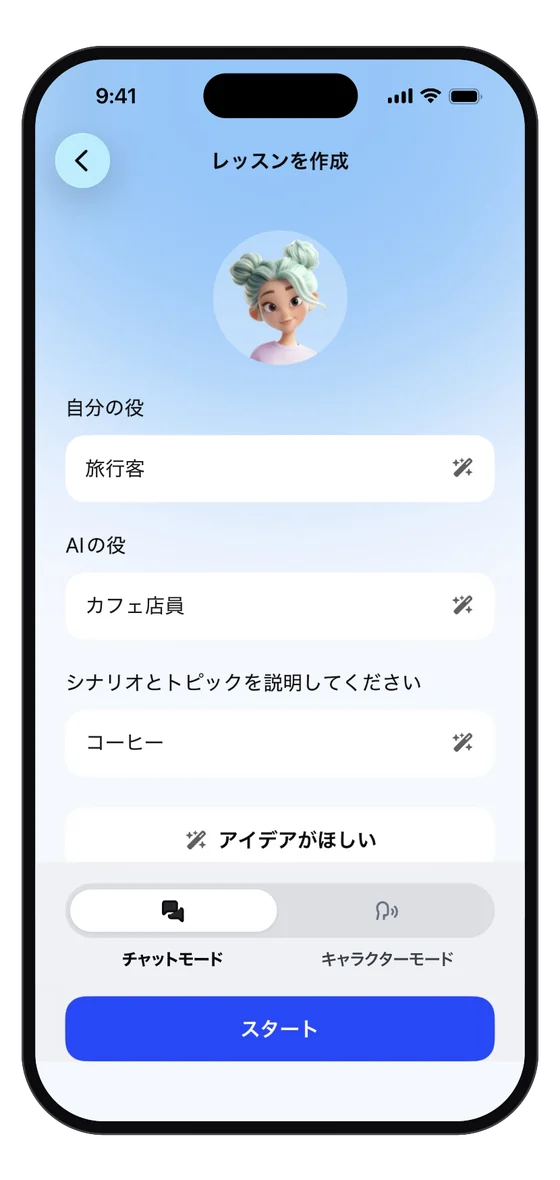
フリートーク
自分の場面を作ってAIと話し、その場でフィードバック。自分のミスから復習レッスンが作られます。
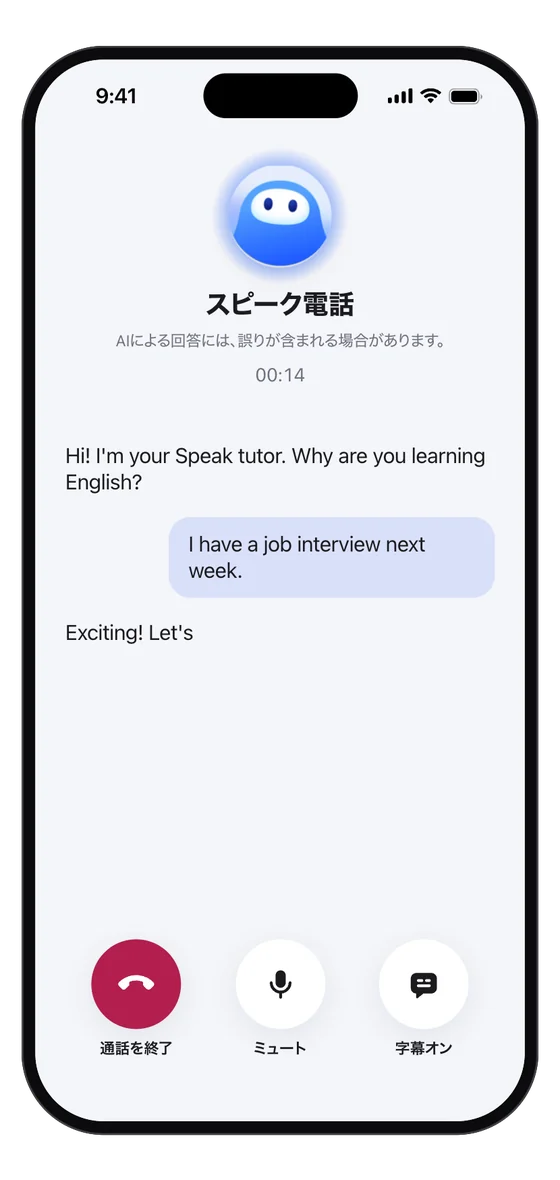
スピーク電話プレミアムプラス
AIの先生と電話で英会話。1回最大10分、月15回まで。前回の話の続きから話せます。
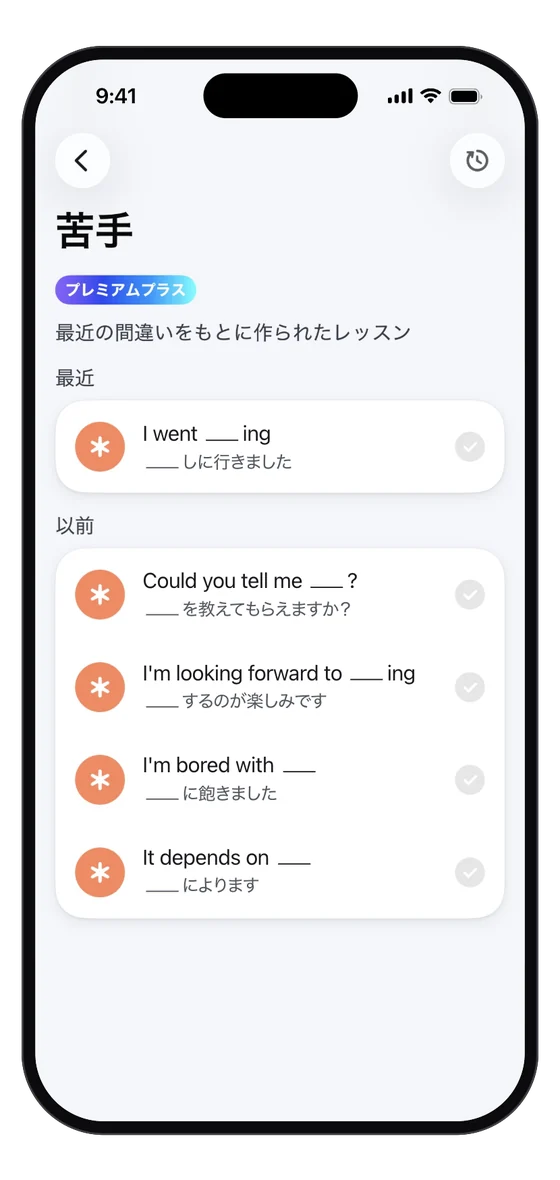
ミスプレミアムプラス
よく間違える表現を集めて、集中して練習。間違いが、そのまま自分だけの教材になります。
1ヶ月180円で試す※初回の方のみ。体験期間中はいつでもキャンセルできます。
この記事では、音声をテキストに変換する「自動音声認識(ASR:Automatic Speech Recognition)」モデルに焦点を当てます。
多くのプロダクトにとって、音声認識の目的はシンプルです。聞き取りにくい音声を、読みやすく整った文章へ変換することです。
話し手が途中で言葉に詰まったり、言い直したり、強いアクセントで話したりしても、きれいな文章として文字起こしできれば、一般的には「認識に成功した」と考えられます。
発話の正確な形よりも、話し手の意図が重要なシステムでは、それが正しい設計です。
たとえば、音声アシスタントに「天気はどう?」と言おうとして、発音が多少崩れてしまっても、天気予報を表示してくれるべきでしょう。
しかし、語学学習では、その「親切すぎる音声認識」が問題になることがあります。
学習者にとって必要なのは、必ずしも読みやすい文字起こしではありません。
本当に必要なのは、自分が実際にどのように話したのかを正確に反映したフィードバックです。
ところが、現代の音声認識モデルは、話し手が伝えようとした意味を推測する能力が非常に高くなっています。その結果、語学指導に必要な手がかりまで消してしまうことがあるのです。
音声認識には2つの考え方がある
まず、音声認識には大きく分けて2つの考え方があります。
1. 意図を重視する音声認識
意図を重視する音声認識は、次のように考えます。
「この人は、何を言おうとしたのか?」
音声から話し手の意図を推測し、最も自然で正しいと思われる文章を出力します。
このように、発話を読みやすく整えた文字起こしは、「正規化された文字起こし」とも呼ばれます。
2. 実際の発話を重視する音声認識
一方、実際の発話を重視する音声認識は、次の問いに答えようとします。
「この人は、実際に何と発音したのか?」
この方法では、言いよどみ、繰り返し、単語の途中での言い直し、文法ミス、発音ミスなどを、そのまま残します。
現在の音声認識モデルのほとんどは、話し手の意図を正しく理解することを重視して設計されています。
しかし、多くの語学学習サービスは、実際の発話がそのまま文字起こしされることを、暗黙の前提としています。
そのため、意図を重視した音声認識モデルを語学学習にそのまま利用すると、いくつかの重大な問題が起こります。
音声認識によって失われる、学習に必要な情報
たとえば、英語学習者が次のように話したとします。
She coming.
しかし、音声認識システムは、それを次のように修正してしまうかもしれません。
She is coming.
また、学習者が次のように言ったとします。
I part- participated in the beta, uh, beta program.
ところが、システムは言い直しやフィラーを取り除き、次のように文字起こしするかもしれません。
I participated in the beta program.
一般的な音声認識モデルの使い方で考えれば、これは成功です。
音声認識の評価に使われるデータセットには、文法的に正しく、流暢なネイティブスピーカーの音声が多く含まれています。言いよどみや言い直しが含まれていないケースも少なくありません。
そのため、実際の発話を忠実に再現した文字起こしよりも、読みやすく整えられた文字起こしのほうが、評価指標上は高いスコアを獲得しやすくなります。
正規化された文字起こしは、より流暢で、文法的にも正しく、読みやすいからです。
しかし、語学指導という観点では、話がまったく異なります。
抜けてしまった動詞、途中での言い直し、同じ単語の繰り返し、「uh」や「um」といったフィラー。
これらは、取り除くべきノイズではありません。
むしろ、学習者がどこで苦戦したのかを最も明確に示す証拠です。
発音だけでなく、文法や流暢さの問題も消えてしまう
この問題は、発音だけに限りません。
たとえば、学習者が英語の「ship」に近い単語を言おうとして、実際には「sheep」に近い発音をしたにもかかわらず、システムが自信を持って「ship」と出力したとします。
語学学習では、学習者が実際にどのように発音したのかを知ることが重要です。
しかし、同じような情報の消失は、文法や流暢さについても起こります。
たとえば、次のようなケースです。
- 冠詞や前置詞など、文法上必要な機能語を省略した
- 文の途中で言い直した
- 同じ表現を何度も繰り返した
- 「I thin-, thought…」のように、途中で自分の間違いを修正した
語学学習において、これらはすべて意味のある情報です。
ところが音声認識モデルが、実際の発話ではなく「最終的に言おうとした自然な文章」を出力するように訓練されていると、こうした情報はすべて消えてしまいます。
なぜ音声認識は発話を自動的に修正するのか
これは、音声認識モデルの不具合ではありません。
現代の音声認識モデルは、音そのものから得られる情報に加えて、「人は通常どのような言葉を使うのか」という強い言語的な予測を組み合わせています。
そして多くの場合、その「通常の話し方」とは、ネイティブスピーカーの話し方を意味します。
この仕組みがあるからこそ、現代の音声認識モデルは、周囲の雑音やアクセント、曖昧な発音があっても、話し手の意図を高い精度で理解できます。
ツールの操作、対話型AI、会議の文字起こしなどでは、話し手の意図を復元することが正しい目標です。
会議の議事録に、「えーと」や「あの」といった言葉をすべて残してほしい人は、ほとんどいないでしょう。
しかし、語学学習者を評価する場合には、この目標は適切ではありません。
一般的な音声認識の評価指標が、語学学習に向かない理由
一般的な音声認識では、「単語誤り率(WER:Word Error Rate)」などの指標を使ってモデルを評価します。
これは、音声の中に含まれていると想定される単語を、モデルがどれだけ正しく出力できたかを測る指標です。
しかし、評価用データセットの多くでは、人間のアノテーターが字幕やキャプションとして読みやすいように、文字起こしをすでに整えています。
つまり、モデルが正解として学習する文章そのものが、すでに正規化されているのです。
その結果、一般的な音声認識のベンチマークで最も高いスコアを獲得するモデルが、語学指導には最も向いていない可能性があります。
なぜなら、そのモデルは、学習者特有の言いよどみや文法ミス、発音ミスを消し、自然な文章へ修正する能力によって、訓練され、評価されているからです。
言い換えれば、学習者の発話をきれいに消してしまう能力が高いほど、一般的な評価では優秀と判断される可能性があるのです。
語学学習サービスで起こる2つの問題
この仕組みは、語学学習サービスに2つの大きな問題をもたらします。
1. 学習者が改善の機会を失う
音声認識が発話を自動的に修正してしまうと、学習者は「自分の文章は正しかった」と思ったまま学習を終えてしまいます。
たとえば、実際にはフィラーを何度も使っていたとしても、文字起こしの段階で削除されていれば、システムは「フィラーが多く使われています」とフィードバックできません。
間違いが記録されなければ、その間違いについて指導することもできないのです。
2. システムの精度が、実際以上に高く見える
一般的な評価指標では、モデルが話し手の意図した文章を出力できれば、高く評価されます。
しかし、その過程で、学習者が実際に発した言葉やミスが省略されている可能性があります。
つまり、システムは学習者の発話を正確に認識したのではなく、学習者が言おうとした文章を推測しているだけかもしれません。
それでも評価上は「正解」と判断されるため、実際の語学指導能力よりも、システムの性能が高く見えてしまいます。
語学学習には、1種類ではなく2種類の文字起こしが必要
1種類の文字起こしだけで、すべての役割を果たすことはできません。
学習者が画面上で見る文字起こしは、読みやすいものであるべきです。
言いよどみや繰り返しを適度に整理した文章のほうが、学習体験は親しみやすくなります。また、その後の処理を担当する大規模言語モデル(LLM)にとっても、整えられた文章のほうが扱いやすい場合があります。
そのため、UI上では読みやすく整えた文字起こしを表示するのがよいでしょう。
一方で、学習者へのフィードバックを生成するシステムは、実際の発話を忠実に記録したデータを使う必要があります。
そこには、次のような情報が残されていなければなりません。
- 言いよどみ
- 単語や表現の繰り返し
- 途中まで発音した単語
- 自分で行った言い直し
- 文法上必要な単語の省略
- 発音の間違い
語学学習において、流暢でない発話を含む生の文字起こしは、単なるノイズではありません。
それは、学習者の課題を示す証拠です。
どこで流暢さが途切れたのか。どこで自信を失ったのか。どの発音が目標からずれたのか。そして、どの部分に対して修正やコーチングを行うべきなのか。
実際の発話を忠実に残すことで、初めてこれらの情報が見えてきます。
まとめ:語学学習に最適な音声認識とは
音声認識技術は、話し手が意図した文章を推測する能力を、ますます高めています。
しかし、語学学習においては、意図した文章を正しく復元することと、学習者の上達を支援することは、必ずしも同じではありません。
読みやすく整えられた文字起こしが、常に優れた文字起こしであるとは限らないのです。
モデルが「uh」を削除し、文法を自動的に修正し、発音を間違えた単語を本来の単語へ置き換えてしまえば、学習者が上達するために必要だった証拠まで消えてしまいます。
語学学習者にとって最適な音声認識システムとは、最も賢く見えるシステムではありません。
正直で的確なフィードバックを提供できるだけの精度を持ち、学習者が実際にどのように話したのかを正しく捉えられるシステムです。
